
Чистка семантического ядра — это отбор запросов, на которые сайт может дать полезный ответ. Удалить явные дубли недостаточно: нужно отделить чужую географию, неподходящие услуги, информационный спрос и неоднозначные формулировки.
Наш внутренний алгоритм предлагает сначала убрать массовый мусор, затем разбирать сомнительные слова и только после этого переходить к кластеризации. Сохраним эту последовательность, добавив журнал решений и проверку спорных запросов.
Сохраните исходную выгрузку
Работайте с копией. В исходном файле оставьте запрос, источник, дату, регион и режим частотности. Если данные собраны в разных условиях, сначала пометьте это. Иначе вы можете сравнить общую частоту по России с точной частотой в одном городе и принять разницу за ошибку.
Создайте отдельные листы или статусы: «Коммерческие», «Информационные», «На проверку» и «Исключены». Для исключённых записывайте причину. Такой журнал помогает пересмотреть фильтр, когда бизнес добавит новую услугу или регион.
Шаг 1. Нормализуйте формат
Уберите пробелы по краям и случайные повторяющиеся пробелы внутри фраз. Сохраните один запрос на строку. HTML-фрагменты и лишние пустые строки после копирования можно убрать через очистку текста ITSEO.
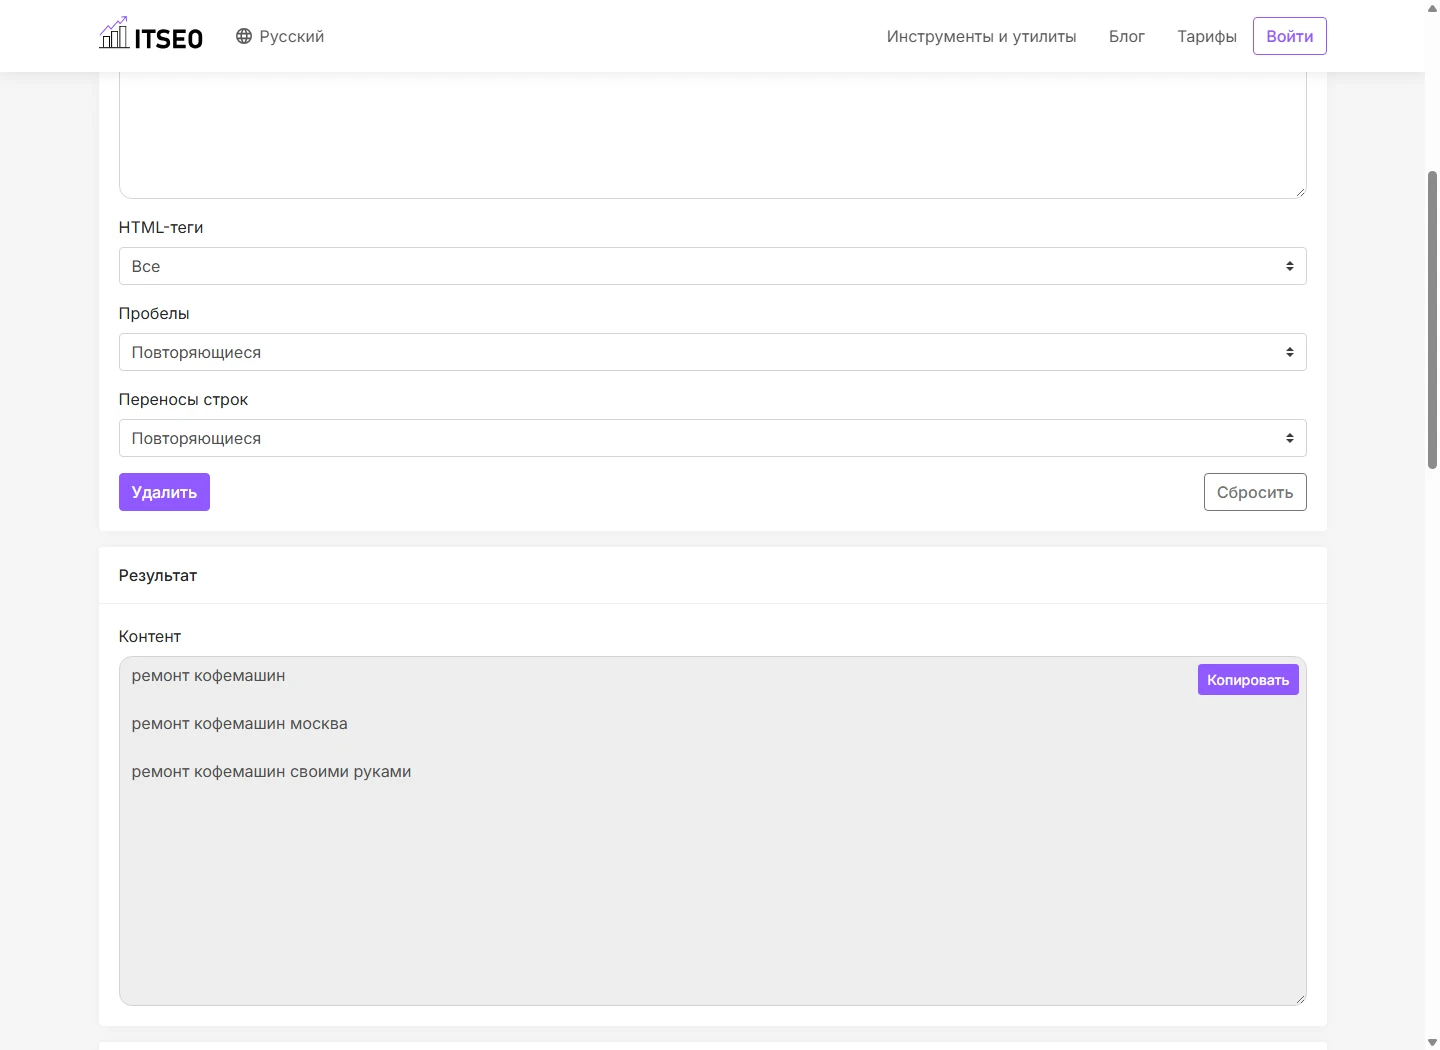
Не используйте режим удаления всех пробелов: он склеит слова и повредит запросы. Также не удаляйте операторы Wordstat из единственной копии списка. При необходимости храните отдельно исходное выражение с операторами и обычную фразу для анализа.
Шаг 2. Удалите точные дубли
После нормализации сравните фразы целиком. Учебные строки «ремонт кофемашин» и «ремонт кофемашин» становятся одним запросом. При объединении сохраните сведения об источниках: фраза могла прийти из подсказок, статистики сайта и структуры конкурента.
Не удаляйте автоматически перестановки слов и близкие формулировки. «Ремонт кофемашин» и «кофемашины ремонт» могут попасть в один кластер, но вопрос об их объединении решается позже, по интенту и выдаче.
Шаг 3. Разберите минус-слова по контексту
| Учебный запрос | Решение | Причина |
|---|---|---|
| ремонт кофемашин москва | Коммерческий список | Соответствует услуге в выбранном городе. |
| ремонт кофемашин своими руками | Информационный список | Нужна инструкция, а не страница заказа ремонта. |
| вакансии ремонт кофемашин | Исключить из ядра услуги | Другой пользовательский сценарий. |
| ремонт кофемашин спб | Проверить географию бизнеса | Не подходит московской мастерской без работы в Петербурге. |
| ремонт кофемашин бесплатно | На проверку | Возможен спрос на гарантийный ремонт. |
Не назначайте слово универсальным минусом без просмотра фраз. «Бесплатно» может обозначать неподходящий запрос, а может относиться к реальной диагностике по условиям сервиса. Название чужого бренда тоже не всегда мусор: ремонт конкретной марки может быть вашей услугой.
Шаг 4. Отделите информационный спрос
Фразы «как», «почему» и «что делать» часто требуют объяснения. Перенесите полезные запросы в будущий контент-план, а не удаляйте весь лист. Статья о признаках неисправности может помочь пользователю принять решение, хотя её задача отличается от страницы записи на ремонт.
Сомнительные фразы проверьте через анализ выдачи. Посмотрите, какие типы страниц отвечают на них в нужном регионе. Если выдача смешанная, сохраните пометку и вернитесь к вопросу при распределении запросов.
Шаг 5. Проверьте частотность без автоматического удаления всех нулей
Используйте проверку частоты Wordstat с одинаковым регионом и режимом для сопоставляемых фраз. В исходном алгоритме нулевые и единичные значения предлагалось удалять. Для универсального процесса это слишком жёстко: редкий запрос может быть ценным для узкой услуги, а новая тема — ещё не иметь устойчивой статистики.
Оставляйте коммерчески важные фразы, если бизнес способен ответить на них и есть дополнительные признаки спроса. Сезонные запросы проверяйте в контексте времени. Частотность не равна числу уникальных клиентов, а суммы по пересекающимся фразам не дают точный размер рынка.
Структура рабочего файла, которая сохраняет решения
Для серьёзной чистки ядра нужны не только запрос и частота. Добавьте исходную фразу, нормализованную фразу, источник, регион, тип частоты, дату сбора, статус и причину решения. По мере проверки появятся пометки об услуге, интенте и спорном слове. Такой файл объясняет, почему строка осталась или ушла, и позволяет изменить решение без повторного парсинга всех источников.
Сохраняйте исходную строку отдельно от нормализованной. Это важно для выражений с операторами, названий моделей и формулировок, где символы несут смысл. Техническая очистка может подготовить ключ для сравнения дублей, но не должна уничтожать доказательство того, что именно было выгружено. Для частоты также оставьте источник, чтобы ошибку сопоставления можно было проверить по первичному файлу.
| Поле | Назначение | Учебное значение |
|---|---|---|
| Исходный запрос | Сохранение первичной выгрузки | ремонт кофемашин Москва |
| Ключ для сравнения | Поиск точных технических дублей | ремонт кофемашин москва |
| Режим частоты | Понимание сопоставимости | Зафиксированный режим и регион. |
| Статус | Следующее действие | Коммерческий, информационный, проверка, исключён. |
| Причина | История смыслового решения | Компания не оказывает услугу в указанном городе. |
Нормализация: что допустимо автоматизировать
Приведение регистра и повторяющихся пробелов удобно выполнять в отдельной колонке для сравнения. Неразрывный пробел после копирования из документов может выглядеть обычным, но мешать поиску дублей. Перед удалением строк убедитесь, что оба варианта преобразованы одинаково. Если отличия связаны со скрытыми символами, чистка формата уменьшит список без потери самостоятельного смысла.
Не объединяйте по нормализованному ключу всё, что похоже визуально. У моделей отличаются цифры, у услуг — приставки и уточнения, у географии — окончания и состав названия. Например, «ремонт кофемашины» и «ремонт кофемолки» относятся к разным объектам. Автоматическая замена по корню слова может незаметно удалить полезное направление. Проверяйте результаты преобразования до применения к основной таблице.
При объединении одинаковых фраз сохраните список источников и не складывайте частоты без понимания данных. Два инструмента могли измерить одну и ту же фразу в одном регионе; сложение даст искусственно завышенное значение. Если условия отличаются, значения лучше хранить отдельно или выбрать подтверждённый режим для задачи. Отбор первичного значения должен быть описан, а не зависеть от случайного порядка строк.
Как работать со словарём сомнительных выражений
Проверяйте фразы, а не только отдельное слово
Соберите часто встречающиеся слова, которые вызывают вопросы: «бесплатно», «скачать», «вакансии», названия городов, конкурентов и соседних продуктов. Для каждого откройте все содержащие его фразы и распределите решения по контексту. Только после такой выборки можно создавать автоматическое правило. Один просмотренный пример не подтверждает, что остальные употребления имеют тот же смысл.
Слово «бесплатно» в «ремонт бесплатно своими руками» и в «бесплатная диагностика кофемашины» ведёт к разным сценариям. Слово «работа» может обозначать вакансию, неисправность или режим устройства. Для названия бренда возможны обслуживание, покупка запчастей и поиск официального сайта. У словаря должны быть не только слово и команда, но и исключения, примеры и владелец правила.
Разделяйте исключение из услуги и исключение из проекта
Запрос о вакансии не подходит посадочной ремонта, но может быть полезен кадровому разделу компании. Инструкция своими руками может попасть в блог. Вопрос о гарантии может стать блоком коммерческой страницы, а не отдельной статьёй. Поэтому используйте статусы маршрутизации. Формулировка «удалить мусор» скрывает разные решения и затрудняет согласование с бизнесом.
Храните исключённые группы до завершения проверки. Если после чистки полностью исчезло направление, сначала выясните, оно не нужно или его случайно захватил слишком широкий фильтр. Для важных услуг полезно сверить итоговый файл с перечнем предложений компании. Такой контроль обнаруживает потери покрытия, которые не видны по общему количеству оставшихся строк.
География, бренды и неоднозначность: отдельные разборы
Географию проверяйте по фактической зоне работы. Название города может встречаться в адресе филиала, доставке, названии компании или пользовательском вопросе. Не удаляйте строку только по справочнику географических названий. Если бизнес обслуживает несколько регионов, пометьте их и планируйте соответствующие условия сбора. Для города, где услуги нет, не создавайте посадочную с ложным обещанием.
Брендовые запросы разделяйте на собственный бренд, обслуживаемые марки и имена конкурентов. Обслуживаемая марка может иметь высокую ценность для сервиса. Запрос о конкретном конкуренте часто обозначает желание попасть на его сайт, но встречаются и осмысленные сравнительные вопросы. Для них нужен честный полезный материал, а не чужое имя, вставленное в метатеги собственной услуги.
Неоднозначные фразы отправляйте на проверку выдачи. Запрос «кофемашина ремонт комплект» может относиться к набору запчастей, а не к заказу работ. Посмотрите несколько результатов и типы страниц, сохраните короткое объяснение. Если результатов недостаточно или интент смешанный, не выдавайте гипотезу за подтверждённый вывод: оставьте статус проверки и укажите, какие сведения помогут принять решение.
Учебный проход: как один фильтр может уничтожить полезную группу
Представим, что в списке встретилось много запросов о ручном ремонте. Редактор решил исключить все строки со словом «сам». В результате исчезли не только инструкции, но и «самовывоз после ремонта кофемашины». Причина — поиск подстроки вместо проверки нужного контекста. Подобные ошибки особенно опасны при массовом удалении, потому что общий объём ядра всё ещё выглядит правдоподобно.
Правильный процесс сначала выделяет найденные строки в отдельную выборку, затем проверяет разные употребления и применяет решение только к подтверждённым случаям. Если правило постоянно требует исключений, возможно, его стоит заменить более узким. Повторите контроль на небольшой случайной выборке удалённых фраз и на важных товарных или сервисных направлениях. Цель — обнаружить ошибку до кластеризации, когда её труднее заметить.
Все числа и запросы в таком разборе служат учебному процессу. Для собственного файла сохраняйте реальные количества до и после этапа, но не ставьте цель удалить заданный процент. Большое сокращение может быть правильным в шумной выгрузке, а может указывать на потерю целой услуги. Объяснение результата должно опираться на группы решений и покрытие бизнеса.
Как принять очищенное ядро перед кластеризацией
Проверьте технические дубли, сохранность источников, режимы частоты и понятность статусов. Затем вручную пройдите репрезентативную выборку коммерческих, информационных, спорных и исключённых строк. Включите фразы с редкими словами, географией и брендами. Если ошибочное правило найдено, пересмотрите всю связанную группу, а не только обнаруженную строку.
Согласуйте спорные решения с человеком, который понимает ассортимент и услуги. SEO-специалист может не знать, что компания начала обслуживать новую марку или прекратила работать в одном районе. Решение о соответствии бизнесу должно иметь актуальный источник. После согласования зафиксируйте версию файла и список вопросов, оставшихся открытыми.
На этом этапе не нужно заново писать полный алгоритм сбора или назначать каждую фразу посадочной. Чистка заканчивается понятным списком пригодных запросов и журналом исключений. Следующий материал о кластеризации превращает его в карту страниц. Разделение этапов помогает локализовать ошибки: можно понять, потеряли ли запрос при отборе или неверно назначили уже подходящую фразу.
Проверьте качество итогового списка
- Нет точных дублей после нормализации.
- Регион и услуги соответствуют бизнесу.
- Информационные запросы сохранены отдельно.
- Спорные фразы проверены по выдаче.
- Исключения имеют понятную причину.
- Настройки сбора частоты зафиксированы.
Далее переходите к кластеризации и карте страниц. Если ещё не собраны исходные маски, начните с сбора семантического ядра. Режимы частоты подробнее разобраны в руководстве по Wordstat.
Три примера ошибок, которые не видны по размеру ядра
Склеивание моделей при очистке символов
Если запрос содержит номер модели, знак или буквенный суффикс может отличать один продукт от другого. Массовое удаление дефисов и цифр делает список внешне аккуратнее, но иногда объединяет несовместимые предложения. До такого преобразования найдите несколько реальных моделей из ассортимента и проверьте результат. Сохраните исходную строку и используйте отдельный ключ только там, где преобразование не уничтожает значимое различие.
Для технических услуг это относится также к типу устройства и комплектующим. Запрос о ремонте отдельного узла не всегда равен ремонту всего аппарата. Если компания продаёт запчасти и оказывает услуги, смысловой отбор должен сохранять эти направления отдельно. Иначе после чистки можно получить большую общую группу, которая не подходит ни каталогу деталей, ни странице заказа работ.
Подтягивание частоты не к той строке
После сортировки двух файлов значения нельзя сопоставлять только по номеру строки. Используйте подтверждённый ключ запроса и точное соответствие, затем проверьте несколько совпадений и отсутствующих значений вручную. Нормализованные пробелы помогают соединению, но исходные выражения и режимы должны оставаться доступными. Если в одном файле присутствуют операторы, заранее определите, по какому полю выполняется связь.
Отсутствующее значение обозначайте отдельно от измеренного нуля. Первая ситуация означает, что данные не найдены или не получены; вторая — результат конкретного измерения. Если заменить все пропуски нулями и удалить строки, исчезнут фразы, которые вообще не проверялись. Перед чисткой по частоте посчитайте пропуски и выясните причину: ошибка соединения, неполная выгрузка или ограничение сбора.
Исключение по целой теме вместо конкретного интента
Список информационных запросов может содержать и полезные вопросы будущих клиентов, и действительно нерелевантные инструкции. Разделите эти решения. Вопрос о сроке службы устройства способен помочь выбору, а поиск учебной вакансии относится к другому сценарию. Не удаляйте всю группу только потому, что коммерческая посадочная не отвечает на неё. Сохраните полезные вопросы для отдельной содержательной задачи.
При проверке качества попросите другого специалиста пройти небольшой набор исключённых фраз и объяснить решения по журналу. Если причину невозможно понять без устного комментария, уточните правило и описание. Этот просмотр полезен не ради формальной второй проверки, а для выявления скрытых предположений о бизнесе и неоднозначных фильтров. Особенно внимательно рассматривайте слова, которыми удалена большая группа строк.
В финальной версии сохраните отдельный список нерешённых вопросов: новые услуги, неизвестная география, неясная модель и недостаточные данные частоты. У каждого вопроса должен быть следующий шаг. Не смешивайте их с подтверждённым мусором и не передавайте в кластеризацию как окончательно принятые. Тогда карта страниц будет опираться на понятный отбор, а пересмотр потребует вернуться только к конкретным спорным группам.
Такой контроль завершает чистку на уровне пригодности данных. Общее количество строк, суммарная частота и доля удаления остаются описательными показателями, а не самостоятельной оценкой качества. Хороший файл сохраняет покрытие реальных услуг, различает полученные и отсутствующие значения и позволяет восстановить причины решений. Именно эти свойства помогают следующему этапу, даже если ядро получилось меньше ожидаемого.
Частые вопросы
Сколько запросов должно остаться после чистки?
Универсального количества нет. Оценивайте покрытие услуг и пользовательских задач, а не процент удалённых строк.
Можно ли полностью автоматизировать отбор?
Техническую нормализацию и очевидные исключения — да. Неоднозначные слова и связь с возможностями бизнеса требуют проверки человеком.


