
Проверять robots.txt и sitemap.xml лучше вместе: первый файл задаёт правила обхода, второй помогает роботу обнаружить важные URL. Если карта отправляет робота к закрытым, перенаправляемым или несуществующим страницам, сайт подаёт противоречивые сигналы.
Этот алгоритм развивает блок служебных файлов из нашего внутреннего SEO-аудита. Цель проверки — убедиться, что нужные страницы доступны для сканирования и правильно представлены в карте сайта.
Шаг 1. Проверьте, какие файлы доступны роботу
Откройте https://example.com/robots.txt на основном домене. Убедитесь, что ответ содержит текст правил, а не страницу входа, защитную проверку или HTML ошибки. Запишите HTTP-код и URL после перенаправлений. Затем найдите директиву Sitemap и откройте указанный адрес.
На сайте может быть несколько карт, объединённых sitemap-индексом. Поэтому отсутствие файла именно по адресу /sitemap.xml ещё не доказывает проблему: карта может называться иначе. Используйте адрес из robots.txt, настроек CMS или кабинета вебмастера.
Шаг 2. Проверьте robots.txt в валидаторе
Откройте валидатор robots.txt и sitemap ITSEO. Укажите домен для проверки опубликованных файлов либо вставьте текст в режиме проверки содержимого. Второй вариант удобен перед изменением файла: можно проверить подготовленную версию до загрузки на сайт.
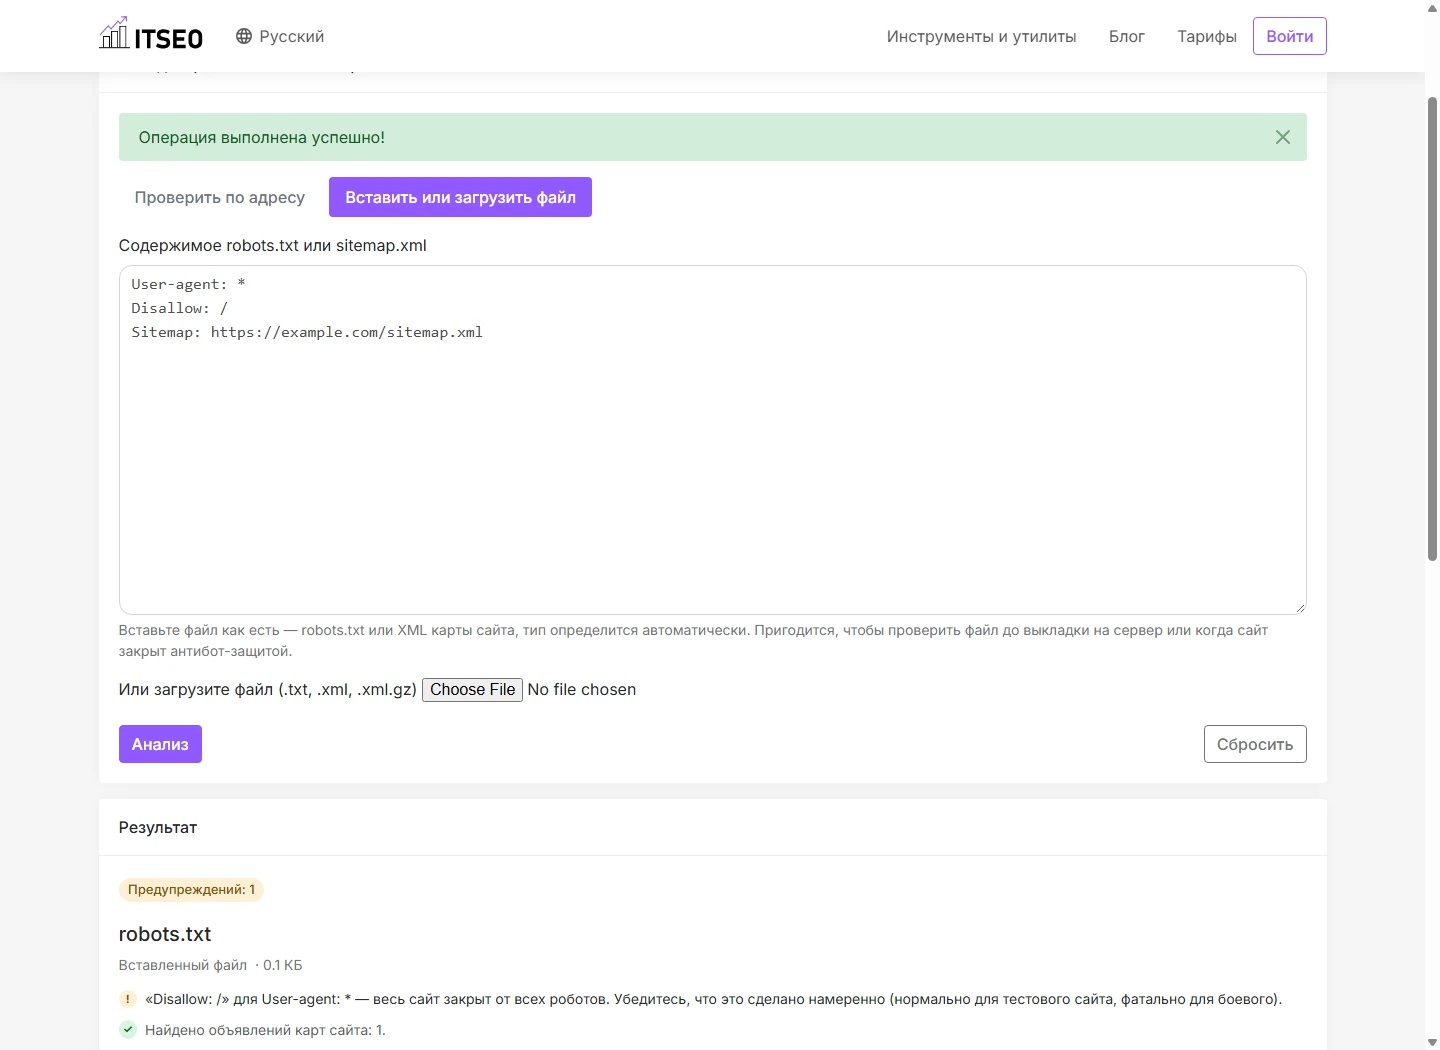
Сначала проверьте группы User-agent и запреты Disallow. Особое внимание уделите случайному Disallow: /, оставшемуся после разработки. Затем оцените конкретные пути: закрытые параметры поиска могут быть служебными, но запрет всего каталога способен лишить робота доступа к посадочным страницам.
Проверьте также, нет ли отдельных правил для Googlebot и Yandex. Результат зависит от группы, которую применит конкретный робот; просмотр только общей группы User-agent: * недостаточен.
Шаг 3. Разделите обход и индексацию
robots.txt регулирует получение файлов роботом. Запрет обхода не служит надёжной командой удалить известный URL из поиска. Для исключения страницы из индекса используют подходящие директивы индексации, а робот должен иметь возможность их прочитать.
| Ситуация | Что проверить |
|---|---|
| Посадочная должна быть в поиске | Обход разрешён, нет noindex, canonical согласован с целевым URL. |
| Служебная страница не нужна в поиске | Выбран осмысленный способ исключения; запреты не противоречат друг другу. |
| Раздел содержит приватные данные | Доступ защищён авторизацией. robots.txt не заменяет защиту. |
Проверяйте и HTML-тег robots, и HTTP-заголовок X-Robots-Tag. Исправленный файл robots.txt не отменяет запрет, который CMS продолжает выдавать внутри страницы или в заголовках ответа.
Шаг 4. Проверьте содержимое sitemap
Карта должна быть корректным XML-документом с абсолютными адресами. Включайте канонические URL, которые хотите показывать в поиске. Удаляйте из карты ссылки на ошибки, ненужные редиректы и заведомо неиндексируемые страницы. Поле lastmod обновляйте при значимом изменении содержимого, а не при каждом обращении к файлу.
Проверьте разные шаблоны: несколько категорий, товаров, услуг и статей. При большой карте проверка нескольких адресов — только выборка. Для более широкого контроля выгрузите URL и запустите проверку HTTP-статусов или обход аудитором.
Шаг 5. Устраните противоречия и проверьте повторно
Учебный пример: в sitemap находится /services/repair/, но группа робота закрывает весь /services/. Сначала решите, должна ли страница участвовать в поиске. Для полезной услуги исправьте ошибочный запрет и проверьте noindex; для служебного URL уберите его из карты. Не открывайте весь сайт автоматически только ради зелёного отчёта.
После изменения повторно загрузите опубликованные файлы, а затем проверьте их в Google Search Console и Яндекс Вебмастере. Эти сервисы показывают обработку именно соответствующим поисковиком. Запрос переобхода сообщает об изменении, но не назначает обязательный срок появления страницы в поиске.
Как проверить правила на конкретных URL
Сначала определите нужное поведение
Перед редактированием файла составьте список проверочных адресов: главная, категория, товар или услуга, статья, поиск по сайту, сортировка, фильтр и кабинет. Для каждого укажите, нужен ли обход и нужен ли показ в поиске. Эти два решения могут различаться. Например, страница должна быть доступна роботу для чтения директивы исключения, хотя её не планируют показывать как самостоятельную посадочную.
В рабочей таблице оставьте исходный URL без ручного упрощения. Проверяйте параметры в том виде, в котором их формирует приложение: порядок, символы и регистр пути могут иметь значение для конкретных правил. Если вы тестируете только чистый адрес категории, запрет для её параметризованных вариантов останется незамеченным. Добавьте хотя бы один похожий путь, который должен оставаться доступным: он поможет обнаружить слишком широкий шаблон.
Не переносите правила с чужого сайта
Популярный шаблон robots.txt может содержать пути, которых у вашей CMS нет, и пропускать реально используемые разделы. Даже у одинаковой CMS структура зависит от плагинов и настроек. Команда «вставить типовой файл» без проверки маршрутов не подтверждает качество настройки. Сначала выпишите реальные адреса, затем свяжите каждое правило с конкретной группой и поясните, зачем оно добавлено.
Следите за областью действия файла. Правила на основном хосте не становятся автоматически правилами отдельного поддомена. Если каталог расположен на другом хосте или сервис использует нестандартный порт, проверка должна учитывать именно его адрес. Такое разделение особенно полезно, когда основной сайт, блог и приложение обслуживаются разными системами и обновляются независимо.
Разбор учебного файла: открытые страницы и служебные пути
User-agent: *
Disallow: /account/
Disallow: /internal-search/
Allow: /internal-search/help/

Sitemap: https://example.com/sitemap-index.xml
В этом условном примере основные публичные разделы не перечислены в запретах. Кабинет и поиск по сайту закрыты от обхода, а общедоступная справка внутри каталога поиска имеет отдельное разрешение. Такой пример иллюстрирует обсуждение правил, но не служит готовым файлом для любого сайта. Убедитесь, что исключение соответствует поведению нужных вам поисковых роботов, а доступ к кабинету защищён независимо от robots.txt.
Проверочный список должен содержать не только /internal-search/, но и /internal-search/help/, а также похожие пути вне этого каталога. Затем сравните ожидаемые результаты с проверкой в инструменте соответствующего поисковика. Валидатор помогает найти синтаксические вопросы, но не знает, какие страницы владелец бизнеса считает полезными. Это решение должен содержать ваш рабочий список.
Особенно внимательно просматривайте автоматически сгенерированные правила. CMS может обновить файл после установки плагина, а сервер — подменить его другим содержимым. Сохраните копию до изменения, после публикации скачайте файл заново и сравните именно опубликованный текст. Проверка версии в редакторе не обнаружит, что пользователям и роботам продолжает отдаваться старый кеш.
Как разбирать sitemap-индекс и отдельные карты
Начинайте с дерева карт
Sitemap-индекс перечисляет дочерние карты, а не сами посадочные страницы. Сначала проверьте, что каждая дочерняя карта открывается и соответствует заявленному типу. Затем изучайте URL внутри неё. Если индекс доступен, но карта товаров возвращает ошибку, зелёный результат проверки одного индексного файла не описывает состояние товарного каталога. Запишите структуру дерева, чтобы повторный контроль не пропускал новый раздел.
У больших проектов удобно разделять карты по содержимому или стабильным группам: товары, категории, статьи. Это помогает диагностике и обслуживанию, но само по себе не гарантирует более высокие позиции. Важно, чтобы генератор не терял адреса, не создавал повторные записи и не включал промежуточные состояния вроде неопубликованных товаров. Спросите разработчика, какие условия отбора использует генератор.
Проверяйте XML и фактическое состояние URL отдельно
Корректный XML может содержать неправильные адреса. Синтаксическая проверка отвечает на вопрос, можно ли разобрать документ; HTTP-проверка — отвечает ли URL; проверка директив — соответствует ли он плану индексации. Не объединяйте эти результаты в одно «sitemap хороший». В отчёте нужны отдельные статусы, иначе разработчику придётся заново искать, почему файл принят, а полезные страницы продолжают исключаться.
В XML символы должны быть корректно экранированы. Например, разделитель параметров в текстовом представлении адреса записывают как &, чтобы XML-парсер восстановил обычный амперсанд внутри URL. Не подставляйте в карту HTML-код страницы или список адресов без XML-структуры. Если CMS отдаёт сжатый файл, проверьте доступность и корректное чтение именно опубликованного варианта, а не распакованной локальной копии.
Матрица типичных противоречий
| Что обнаружено | Что выяснить | Где исправлять |
|---|---|---|
| URL в карте отвечает редиректом | Это старый адрес или нормализация структуры? | Генератор должен формировать выбранный конечный URL. |
| Товар в карте имеет noindex | Намеренно ли он исключён? | Согласовать условия отбора карты и правила шаблона. |
| Карта перечисляет только часть категорий | Есть ли фильтр по активности, языку или дате? | Проверить выборку данных, а не дописать отдельные строки вручную. |
| Lastmod меняется ежедневно без изменения статьи | Используется ли время генерации файла? | Подставлять дату содержательного изменения страницы. |
| Часть адресов принадлежит тестовому хосту | Из какого окружения пришла настройка домена? | Исправить источник URL и проверить весь документ. |
Для параметризованных страниц сначала выберите политику: какая версия заслуживает отдельного участия в поиске. Не удаляйте из карты все фильтры только потому, что адрес содержит вопросительный знак. Фильтр с самостоятельным ассортиментом и понятным спросом может быть полезным, а пустая комбинация параметров — нет. Решение о ценности страницы принимается по содержанию и назначению, после чего файл отражает выбранную модель.
ТЗ разработчику и безопасная публикация
В задаче укажите источник файла: статический документ, плагин, контроллер или задача генерации. Прикрепите текущую версию, список дефектов и проверочные URL. Опишите ожидаемое содержимое без требования переписать всё с нуля. Если неверные адреса создаёт одна настройка домена, править нужно её, иначе следующая автоматическая генерация вернёт ошибку.
Подготовьте приёмку до публикации. Для robots.txt это список разрешённых и запрещённых адресов по нужным роботам; для sitemap — доступные дочерние карты и примеры URL каждого типа. Включите положительные и отрицательные случаи. Приёмка должна подтверждать одновременно открытость посадочных и сохранение запланированных ограничений, а не только отсутствие предупреждений валидатора.
После публикации проверьте текст и HTTP-ответ снаружи приложения, затем работу кеша и данные кабинетов вебмастеров. Не меняйте несколько несвязанных механизмов без необходимости. Если одновременно перестроить sitemap, перенаправления и canonical, будет труднее определить причину неожиданного поведения. Сохранённая предыдущая версия служит ориентиром для сравнения и восстановления конкретной настройки.
Что проверять регулярно
Повторяйте короткую проверку после обновления CMS, переноса раздела, изменения языковых маршрутов и настройки защиты. Для динамических карт проверьте жизненный цикл страницы: новый товар появился, удалённый исчез, изменённая статья получила актуальную дату. Эти события выявляют ошибки генератора лучше, чем повторная проверка неизменной главной.
Если карты и правила согласованы, дальнейшее исследование отсутствующей страницы относится к отдельной диагностике индексации. Эта статья заканчивается проверкой файлов и условий доступа; причины выбора страницы поисковой системой, качество содержимого и ранжирование подробно разобраны в связанном руководстве. Такое разделение помогает не повторять один и тот же общий чек-лист под несколькими заголовками.
Критерий готовности
- Robots.txt и карты доступны без авторизации и серверных ошибок.
- Правила для конкретного робота соответствуют задачам разделов.
- В sitemap указаны актуальные URL нужных страниц.
- Важные адреса не конфликтуют с noindex и canonical.
- Проверена опубликованная версия файлов, а не только локальный текст.
Если правила корректны, а страница отсутствует в поиске, переходите к диагностике индексации. Когда причиной становятся альтернативные адреса, поможет алгоритм проверки дублей и canonical.
Сверка четырёх списков: CMS, карта, обход и поиск
Выгрузите опубликованные нужные страницы из CMS и сопоставьте их с адресами карты. Затем добавьте URL, обнаруженные по внутренним ссылкам, и сведения из кабинета поисковой системы. Это четыре источника с разным назначением. CMS показывает управляемое содержание, карта — заявленные адреса, обход — пути обнаружения, кабинет — состояние обработки конкретным поисковиком. Разница между ними требует объяснения, а не автоматического добавления всех URL в одну общую карту.
Если новая категория есть в CMS, но отсутствует и в карте, и в обходе, сначала проверьте публикацию и правила генератора. Если она есть в карте, но не найдена по ссылкам, изучите навигацию. Если найдена по ссылкам, но отсутствует в карте, выясните условия отбора. Если присутствует во всех собственных источниках, но не в поиске, дальнейшая задача может выходить за рамки служебных файлов.
При сравнении нормализуйте адреса только по согласованной политике. HTTP и HTTPS, параметры и слеши могут создавать варианты одного документа, но произвольное обрезание пути уничтожит различия. Сохраните исходные значения и отдельный ключ сравнения. Для адреса с параметрами используйте восстановленный URL из XML, а не строку с экранированным амперсандом: техническое представление документа не должно создавать ложное несовпадение.
Учебный пример: CMS публикует статью, генератор карты отбирает только записи одной рубрики, а меню выводит другую подборку. Ошибка проявляется как отсутствие части статей в sitemap, хотя сам XML корректен. Решение находится в условии выборки генератора. Ручное дописывание адресов ненадёжно: следующий запуск снова вернёт прежний результат. В приёмку добавьте новую статью из каждой включённой рубрики.
Проверяйте также обратные различия. Адрес в sitemap может остаться после удаления страницы или смены статуса на черновик. Ссылка из старой статьи может вести на неканонический вариант. Не называйте весь такой список ошибкой карты: часть задач относится к содержанию и внутренней навигации. Сохраните категорию причины, чтобы правильный исполнитель получил понятную область изменения.
Итог сверки — перечень исключений с объяснениями. Для каждой группы должно быть понятно, почему она присутствует в карте или отсутствует в ней, где возник адрес и каким механизмом это поддерживается. Повторяйте сверку после изменения типов публикаций, каталога или языковой структуры. Так проверка охватывает реальную модель генерации, а не заканчивается принятым XML-файлом и случайной выборкой нескольких знакомых страниц.
Для регулярной работы сохраните список исключений отдельно от полного массива. Если служебный адрес отсутствует намеренно, укажите основание один раз и сравнивайте его состояние при пересмотре модели. Если новая категория пропущена ошибочно, это открытая задача генератора. Разделение подтверждённых решений и дефектов не даёт следующей проверке заново создавать одни и те же замечания или молча принимать новую потерю полезного раздела.
Частые вопросы
Нужна ли карта каждому небольшому сайту?
Она полезна для обнаружения URL, но не заменяет внутренние ссылки. Особенно внимательно проверяйте карты больших сайтов и недавно созданные страницы.
Почему валидная карта не привела все страницы в индекс?
Корректность XML не означает, что каждая страница будет выбрана для показа. Отдельно оценивайте содержание, дубли и состояние URL в кабинетах поисковиков.


