
Вы опубликовали страницу, добавили её в sitemap и отправили на переобход. Прошла неделя, а URL всё ещё не находится в поиске. Первая реакция — снова нажать «переобойти» или переписать текст. Но если сервер отдаёт ошибку, в коде остался noindex или "Canonical"? ведёт на другой адрес, новый текст ничего не изменит.
Чтобы не перебирать причины наугад, разложим путь страницы до поиска на четыре этапа:
- поисковик должен узнать об URL;
- робот должен суметь его загрузить;
- страница должна разрешать индексирование;
- поисковик должен признать её самостоятельной и полезной для индекса.
Проверять нужно именно в таком порядке — от технического доступа к содержанию.
Сначала уточните диагноз: «не индексируется» или «не ранжируется»
Это разные проблемы.
- Не индексируется: страницы нет в поисковой базе либо она исключена.
- Не ранжируется: страница находится в индексе, но не показывается в проверяемом диапазоне по нужному запросу.
- Ранжируется другой URL: поисковик знает страницу, однако считает более подходящей другую страницу сайта.
Если инструмент съёма позиций не нашёл домен в топ-100, это не доказывает отсутствие URL в индексе. Начните с проверки индексации конкретной страницы, а затем подтвердите состояние в Яндекс Вебмастере и Google Search Console, если у вас есть доступ.
Шаг 1. Проверьте точный URL
Ошибки начинаются с мелочей. Страница могла быть опубликована по адресу с другим слешем, протоколом, поддоменом или регистром символов:
http://example.ru/page
https://example.ru/page
https://www.example.ru/page
https://example.ru/page/
Для пользователя эти варианты могут выглядеть одинаково, но технически это разные URL. Убедитесь, что проверяете финальный канонический адрес, на который ведут меню и внутренние ссылки.
Если страница только что создана, разумно дать роботу время. Но ожидание оправдано лишь после проверки следующих пунктов.
Шаг 2. Посмотрите HTTP-код и цепочку ответа
Откройте проверку ответа сервера и проверьте URL как минимум в обычном режиме и, если инструмент позволяет, с пользовательским агентом поискового робота.
Для индексируемой страницы ожидается финальный ответ 200 OK.
| Код | Что означает | Что делать |
|---|---|---|
| 200 | страница доступна | переходить к robots и метатегам |
| 301/308 | постоянный редирект | проверять конечный URL и уместность перенаправления |
| 302/307 | временный редирект | выяснить, почему оригинал временно недоступен |
| 401/403 | нужна авторизация или доступ запрещён | открыть страницу роботу, если она должна быть публичной |
| 404/410 | страница отсутствует или удалена | восстановить URL либо убрать его из ссылок и sitemap |
| 429 | слишком много запросов | проверить лимиты и доступ поисковых роботов |
| 5xx | ошибка сервера | исправить приложение, прокси или хостинг |
Отдельно проверьте soft 404: сервер отвечает кодом 200, но страница фактически сообщает «ничего не найдено», содержит пустой шаблон или редиректит все удалённые URL на главную. Поисковик может исключить такой адрес, несмотря на формальный 200.
HTTP-ответ
финальный код, время ответа и цепочку редиректов для одного URL.

Проверка индексации страниц в ITSEO
Шаг 3. Проверьте robots.txt
Файл robots.txt управляет обходом. Одна слишком широкая директива способна закрыть целый раздел:
User-agent: *
Disallow: /catalog/
Вместе с нежелательными фильтрами здесь окажутся все карточки внутри /catalog/.
Проверьте файл через валидатор robots.txt и sitemap ITSEO:
- доступен ли
/robots.txtс кодом 200; - нет ли запрета для нужного робота;
- не закрыта ли родительская директория;
- корректно ли указаны группы
User-agent; - не остался ли запрет от тестовой версии сайта.
Важно: запрет обхода и удаление из поиска — не одно и то же. Если URL уже известен по внешним ссылкам, поисковик иногда может показывать адрес без содержимого. Для осознанного исключения публично доступной страницы используют "Noindex"?, причём робот должен иметь возможность загрузить страницу и увидеть эту директиву.
проверка robots.txt
проверяемый URL, применившуюся директиву и итог «разрешён/запрещён».
Шаг 4. Найдите noindex в HTML и HTTP-заголовках
В HTML страницы запрет выглядит так:
<meta name="robots" content=""Noindex"?, nofollow">
Он может быть задан и HTTP-заголовком:
X-Robots-Tag: "Noindex"?
Проверяйте итоговый серверный HTML, а не только настройку в CMS. Запрет мог прийти из шаблона, SEO-плагина, reverse proxy или заголовка для целого типа файлов.
Частая авария после запуска: на staging-сайте стоял глобальный "Noindex"?, копию перенесли в production вместе с настройкой. Главная открывается, аналитика работает, но поисковому роботу прямо запрещено добавлять страницы в индекс.
После снятия запрета не ждите мгновенного результата. Поисковик должен снова обойти URL и обработать изменение.
Шаг 5. Проверьте canonical
Тег "Canonical"? сообщает предпочтительный адрес среди дублей:
<link rel=""Canonical"?" href="https://example.ru/right-page/">
Если на новой статье "Canonical"? ведёт на главную, старую версию или шаблонную страницу, поисковик получает сигнал: текущий URL не основной.
Проверьте:
- "Canonical"? присутствует один раз;
- адрес абсолютный и открывается;
- конечная страница отвечает 200;
- она не закрыта от индексирования;
- содержание действительно совпадает или близко;
- на самостоятельной странице "Canonical"? обычно указывает на неё саму.
Яндекс рассматривает "Canonical"? как рекомендацию и может её проигнорировать, если страницы сильно различаются или целевой адрес недоступен. Но рассчитывать на это как на исправление ошибки не стоит.
Шаг 6. Убедитесь, что URL есть в правильном sitemap
Sitemap помогает обнаруживать канонические URL, но не гарантирует индексацию. В карту должны попадать страницы, которые вы хотите видеть в поиске:
- с кодом 200;
- без
"Noindex"?; - без редиректа;
- с корректным "Canonical"?;
- в абсолютном формате URL.
Если sitemap содержит удалённые страницы, редиректы и служебные фильтры, он противоречит остальным сигналам сайта. Валидируйте файл, проверьте его код ответа и отправьте в панели вебмастеров.
Для больших проектов полезно делать отдельные карты по типам страниц: товары, категории, статьи. Тогда быстрее видно, какой шаблон перестал индексироваться.
Шаг 7. Найдите путь к странице внутри сайта
URL в sitemap — слабая замена нормальной структуре. Страница-сирота, на которую не ведёт ни одна внутренняя ссылка, выглядит второстепенной и может долго оставаться без обхода.
Проверьте:
- есть ли ссылка из рубрики или категории;
- входит ли страница в хлебные крошки и пагинацию;
- ссылаются ли на неё близкие материалы;
- не доступна ли ссылка только после клика, который робот не выполняет;
- используется ли обычный
<a href="…">, а не обработчик без URL.
Ссылка должна быть полезной читателю. Не нужно помещать сотни новых URL в футер ради обхода — лучше встроить страницу в понятную иерархию.
Шаг 8. Сравните серверный HTML и отрисованную страницу
Иногда человек видит контент, а в исходном ответе сервера почти пусто: текст и ссылки появляются только после выполнения JavaScript. Поисковые системы умеют рендерить JavaScript, но это дополнительный этап, который может задерживаться или завершаться ошибкой.
Проверьте:
- присутствуют ли title, основной текст, "Canonical"? и robots в исходном HTML;
- загружаются ли скрипты без ошибок;
- не требует ли API авторизации или cookie;
- одинаков ли контент для робота и пользователя;
- не закрыты ли JS- и CSS-ресурсы.
Ключевой контент и ссылки надёжнее отдавать с сервера. Особенно это важно для новых страниц, карточек и пагинации.
Шаг 9. Оцените, достойна ли страница отдельного индекса
Если технических запретов нет, причина может быть не в доступе, а в ценности и дублировании.
Поисковик может не выбрать URL, если это:
- почти точная копия другой страницы;
- тонкая страница фильтра без самостоятельной пользы;
- карточка без описания, цены и наличия;
- автоматически созданная комбинация параметров;
- статья, которая пересказывает уже имеющийся материал;
- страница с другим интентом, чем заявлено в title.
Не добавляйте текст «для объёма». Ответьте на практический вопрос: зачем пользователю отдельная страница и что он получит здесь, чего нет на каноническом аналоге?
Сравните выдачу по целевому запросу через SERP checker. Если в топе категории, а вы пытаетесь индексировать короткую карточку, проблема может быть в формате и интенте, а не в длине текста. Методика такого сравнения описана в статье об анализе поисковой выдачи.
Шаг 10. Отправьте на переобход — один раз после исправления
Когда причина устранена:
- убедитесь, что URL отдаёт 200;
- проверьте отсутствие запретов;
- обновите sitemap и внутренние ссылки;
- запросите переобход в панели поисковой системы;
- зафиксируйте дату;
- повторно проверьте статус после нового обхода.
Многократная отправка неисправной страницы не ускорит индексирование. Сначала измените сигнал, затем просите робота увидеть изменение.
Быстрая матрица диагностики
| Наблюдение | Вероятная причина | Первая проверка |
|---|---|---|
| URL никогда не обходился | нет ссылок или sitemap | внутренняя структура и карта сайта |
| Робот получает 403 | защита, CDN, firewall | ответ с user-agent робота |
| URL исключён как дубликат | "Canonical"? или похожая страница | выбранный поисковиком canonical |
| В sitemap есть, в индексе нет | конфликт сигналов или низкая ценность | 200, noindex, "Canonical"?, качество |
| В индексе другой URL | каннибализация или неверный "Canonical"? | релевантные страницы по запросу |
| Пропал после релиза | шаблон, robots, заголовок или редирект | сравнение до/после и журнал изменений |
Чек-лист
- Проверен точный финальный URL.
- Сервер отвечает кодом 200 без лишней цепочки.
- robots.txt разрешает обход конкретной страницы.
- В HTML и
X-Robots-Tagнет"Noindex"?. - Canonical указывает на правильный доступный URL.
- В sitemap находится канонический адрес без редиректа.
- На страницу ведут обычные внутренние ссылки.
- Основной контент доступен в итоговом HTML.
- Страница не дублирует другой URL и решает самостоятельную задачу.
- После исправления запрошен новый обход.
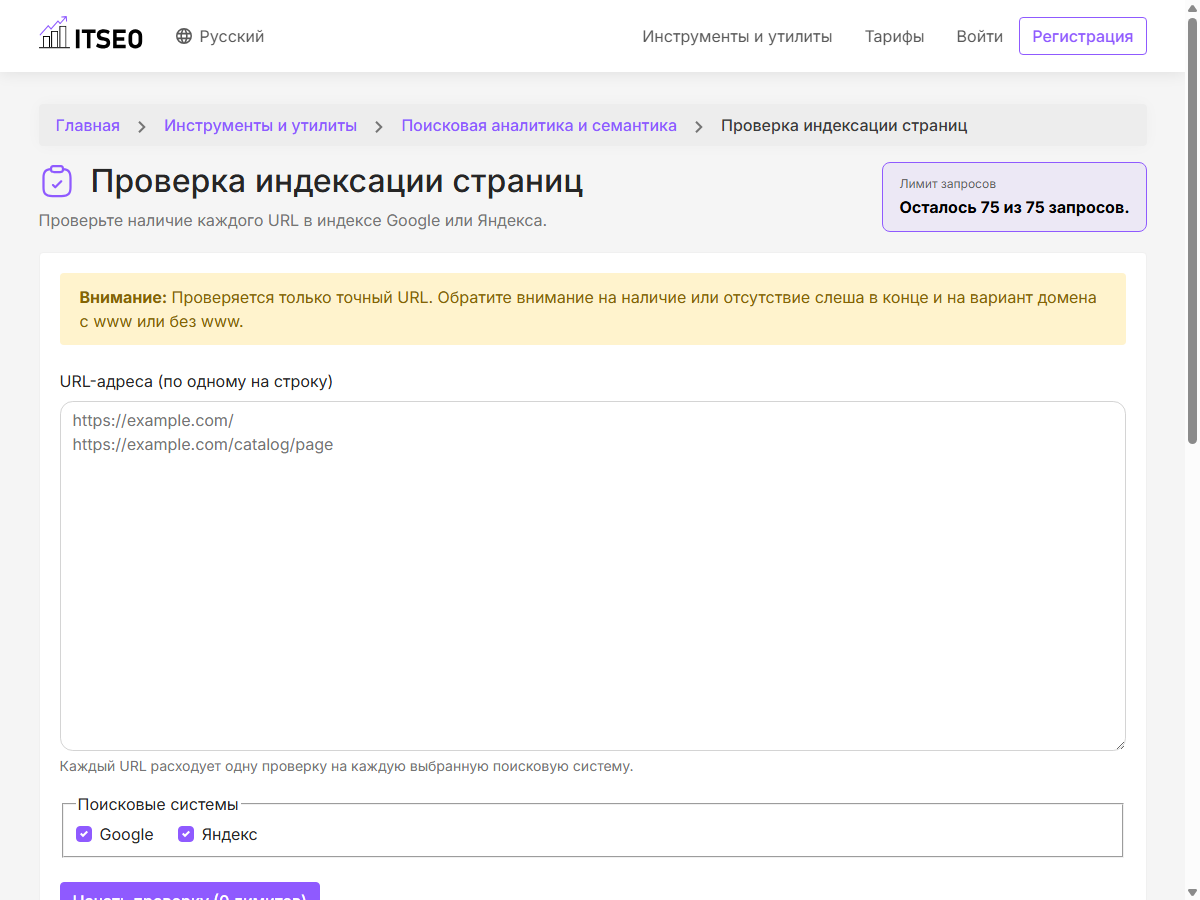
Начните с проверки индексации, затем последовательно проверьте HTTP-ответ и robots.txt с sitemap. Такой порядок обычно быстрее находит причину, чем переписывание текста вслепую.
Источники и полезные материалы
- Яндекс: анализ индексации страницы
- Яндекс: канонический адрес страницы
- Яндекс: управление индексированием через robots.txt
- Google: рекомендации по Sitemap


